
主機側的延遲調校,像是網卡的 interrupt coalescing、中斷跟程式放哪顆 CPU、CPU 隔離與 C-state、kernel bypass,改完都要量收發延遲確認效果,只比平均值會判斷錯。這次把這些調校量過的 70 輪、每一筆收發延遲重新計算,結果有三點:
資料是 70 輪收發延遲實測,每輪 10000 個請求,請求間隔多數是 1 ms(7 輪是 20 µs);回覆程式有的放在隔離的 CPU 1(作業系統不會把其他程式排上去),有的放在一般的 CPU,像 CPU 19、25。每一筆是一個請求的收發延遲:回覆程式收到請求就回,ExaNIC X25 的 port1 對請求和回覆各打一個硬體時戳相減。一輪的 10000 筆由小排到大,各統計量取的位置如下:
| 統計量 | 第幾筆 | 排在它後面的筆數 |
|---|---|---|
| 中位數 | 第 5000 筆 | 5000 |
| p99 | 第 9900 筆 | 100 |
| p99.9 | 第 9990 筆 | 10 |
這一輪的回覆程式沒有綁定 CPU,量測途中被作業系統從 CPU 19 移到 CPU 25 執行,延遲分成兩群:
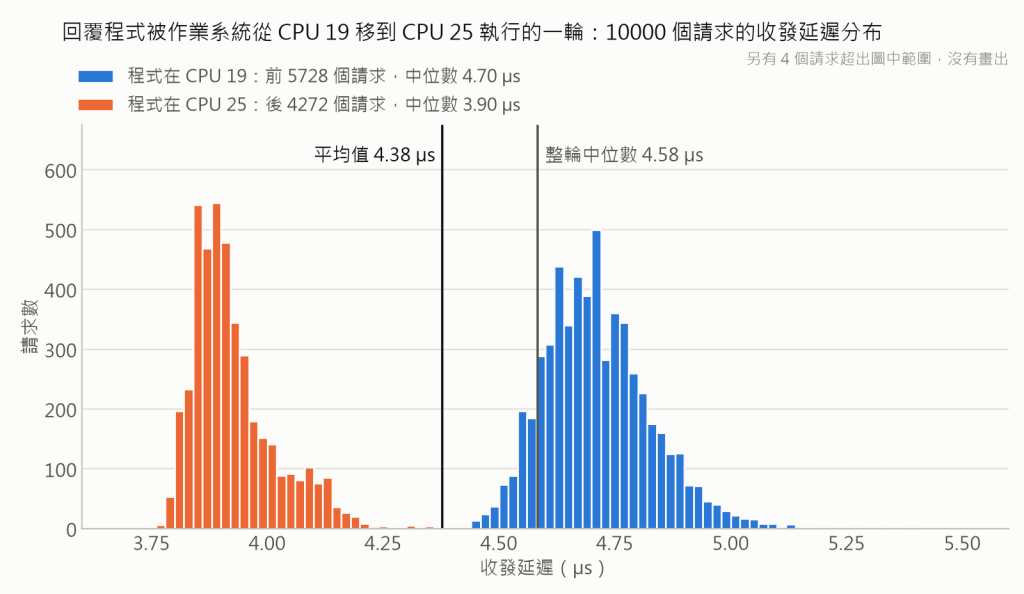
兩群的中位數分別是 3.90 µs(程式在 CPU 25)跟 4.70 µs(程式在 CPU 19),平均值 4.38 µs 落在兩群中間的空檔,整輪的中位數 4.58 µs 也只落在請求較多的那一群,兩個數字都描述不了這一輪。遇到分成兩群的分布,要先查出分群的原因(這一輪是程式執行的 CPU 改變了),再把兩群分開算。
一般的 CPU 25 被其他程式佔滿時,平均值的變化也會誤導:
| 程式在 CPU 25 | 平均值 | 中位數 | 超過中位數 10 倍的請求 |
|---|---|---|---|
| 沒負載 | 3.93 µs | 3.90 µs | 0 個 |
| 被其他程式佔滿 | 4.54 µs | 4.15 µs | 5 個 |
平均值多了 0.61 µs,看起來像整體變慢,但中位數只多 0.25 µs,多出來的大半來自那 5 個超過中位數 10 倍的請求(以下稱為卡頓),最慢的 1548.86 µs。平均值分不出整體變慢跟少數卡頓,兩件事要分開看。
不算每輪最前面兩個請求,70 輪裡有 9 輪出現超過中位數 10 倍的請求,其中 5 輪:
| 情境 | 中位數 | p99.9 | 不算前兩個的最慢值 | 超過中位數 10 倍 |
|---|---|---|---|---|
| 一般的 CPU 25 被佔滿 | 4.15 µs | 5.23 µs | 1548.86 µs | 5 個 |
| 同上,重量一輪 | 4.15 µs | 4.66 µs | 781.89 µs | 1 個 |
| 程式與中斷都在 CPU 19 | 4.04 µs | 4.50 µs | 888.81 µs | 1 個 |
| 程式在 CPU 19 | 4.64 µs | 5.18 µs | 468.90 µs | 1 個 |
| 程式在 CPU 25,閒置時進 C1(重量一輪) | 4.03 µs | 5.52 µs | 60.19 µs | 1 個 |
p99.9 後面只有 10 筆,卡頓少於 10 筆就反映不到 p99.9。這 9 輪都發生在一般的 CPU(19、25),程式在隔離的 CPU 1 的 30 輪一次都沒有。
第一列逐筆畫出來,p99.9 那條線貼著其他請求,5 個卡頓是它的 46 到 296 倍:
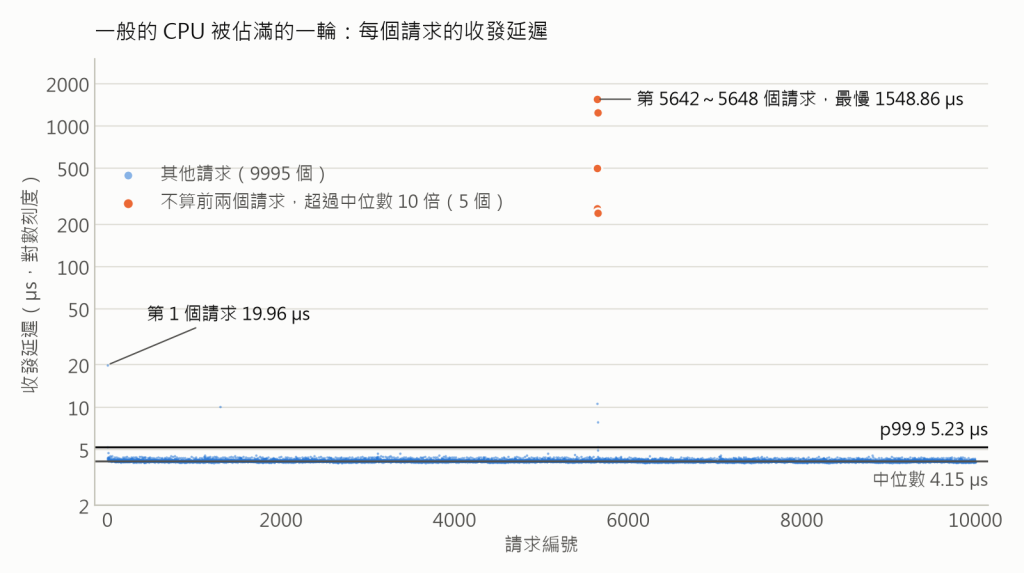
最大值看得到卡頓,但每輪的第一個請求通常也很慢,CPU 被佔滿那張圖裡,第 1 個請求是 19.96 µs,約是中位數的 4.8 倍。70 輪裡有 57 輪最慢的就是第一個請求,各跑法的第一個請求如下:
| 跑法 | 第一個請求 | 約是中位數的 |
|---|---|---|
| kernel | 11.33 到 34.98 µs | 3 到 8 倍 |
| Onload | 390.98 到 429.91 µs | 111 到 331 倍 |
| exasock | 144.98 到 150.82 µs | 65 到 97 倍 |
第二個請求通常也偏慢,70 輪裡有 61 輪,前兩個請求都排在整輪最慢的 10 個裡面。所以用最大值抓卡頓之前,要先拿掉每輪最前面兩個請求,剩下的最大值才能用來判斷卡頓。
抖動常用標準差表示,但一般的 CPU 25 被佔滿那輪,標準差是 20.74 µs,沒負載時只有 0.21 µs,差距幾乎全來自那 5 個卡頓,標準差會被少數慢的請求大幅拉高。
IETF 的 RFC 5481 建議用 PDV(packet delay variation)量抖動:每一筆減掉這輪最快的那筆,再取 p99.9,等於 p99.9 減最小值。PDV 量的是一般請求彼此的差距,跟 p99.9 一樣反映不到少於 10 筆的卡頓,所以卡頓另外用筆數判斷。
同一組設定重量一輪,各統計量最多差多少:
| 程式放在 | 重量組數 | 中位數 | p99 | p99.9 | PDV |
|---|---|---|---|---|---|
| 隔離的 CPU 1 | 12 組 | 2.1% | 3.3% | 4.6% | 18.7% |
| 一般的 CPU 19、25 | 11 組 | 2.0% | 2.3% | 12.2% | 86.1% |
p99.9 後面只有 10 筆、PDV 又是從 p99.9 算的,一兩個慢的請求就能讓它們跳動,要多量幾輪才準;p99 後面有 100 筆,適合抓分布整體往右移。比較調校前後要照這四點:
正式環境不會只為了量測把變更改回去,所以變更前緊接著量一輪當基準,變更後再量一輪跟基準比:
| 項目 | 算法 | 重量時最多差 | 門檻 | 超過時 |
|---|---|---|---|---|
| 中位數 | 第 5000 筆 | 2.1% | 比基準高 5% | 比對設定基線,列為 P2 |
| p99 | 第 9900 筆 | 3.3% | 比基準高 10% | 比對設定基線,列為 P2 |
| p99.9 | 第 9990 筆 | 4.6% | 比基準高 10% | 重量一輪,仍超過列為 P2 |
| 抖動 | PDV(p99.9 減最小值) | 18.7% | 基準的 1.5 倍 | 重量一輪,仍超過列為 P2 |
| 卡頓 | 不算前兩個請求,超過中位數 10 倍的筆數 | 30 輪都是 0 個 | 大於 0 | 交易時段 P1,盤後 P2 |
門檻都抓在重量最大差異的兩倍以上,重量差異是設定沒變、只是再量一輪就會有的起伏,門檻要是訂得比它緊,什麼都沒改也會告警。表裡是程式放在隔離的 CPU 量到的;程式放在一般的 CPU 時,p99.9 重量就差到 12.2%、PDV 差到 86.1%,要先在那台機器上重量幾輪,用量到的差異重訂門檻。
明天把每天的設備巡檢寫成腳本,談要檢查哪些項目、多久跑一次。


 iThome鐵人賽
 看影片追技術